Behawioralne Ryzyko AI · Jakość Decyzji · Nadzór nad AI

Większość regulacji AI skupia się na tym, co AI robi źle.

Decision Integrity™ zajmuje się tym, co AI robi nam — jak wzmacnia błędy poznawcze, osłabia krytyczne myślenie i niepostrzeżenie zmienia sposób, w jaki podejmujemy decyzje.

Decision Integrity™ to metodologia Stefana Podedwornego, która chroni jakość ludzkich decyzji w środowiskach wspieranych przez AI. Łączy ekonomię behawioralną z nadzorem nad AI, dostarczając ramy, narzędzia i wskaźniki pozwalające mierzyć i ograniczać ryzyka, które tradycyjne podejścia pomijają.

Wypróbuj narzędzie AI Act

Kluczowa Koncepcja

Czym jest Behavioral AI Risk?

Behavioral AI Risk to cała kategoria ryzyk, którą tradycyjny nadzór nad AI pomija. Podczas gdy większość regulacji AI skupia się na awariach technicznych, prywatności danych czy uprzedzeniach algorytmicznych, Behavioral AI Risk bada coś subtelniejszego i groźniejszego:

Jak systemy AI systematycznie wpływają na ludzki osąd, wzmacniają błędy poznawcze i obniżają jakość naszych decyzji.

Kluczowe Mechanizmy

Wzmacnianie Błędów Poznawczych

AI wzmacnia błąd potwierdzenia, efekt zakotwiczenia i heurystykę dostępności — przez co nasze myślenie staje się mniej samodzielne, a nie lepiej poinformowane.

Efekty Framingu Semantycznego

Sposób, w jaki AI porządkuje i przedstawia informacje, subtelnie wpływa na to, jak interpretujemy fakty, dokonujemy wyborów i wyciągamy wnioski.

Degradacja Kontekstu (ContextRot)

W dłuższych interakcjach z AI jakość kontekstu stopniowo się pogarsza. Halucynacje się nawarstwiają, pojawia się dryf znaczeniowy, a fałszywe poczucie pewności narasta.

Fałszywa Pewność

AI przedstawia zmyślone informacje z taką samą pewnością języka co zweryfikowane fakty, przez co odróżnienie wiedzy od zmyślenia staje się niemal niemożliwe.

Erozja Krytycznego Myślenia

Gdy AI dostarcza natychmiastowe, spójne odpowiedzi, słabnie potrzeba kwestionowania, weryfikowania i namysłu. Z czasem rodzi to zależność od systemów, które jedynie symulują rozumienie.

Dlaczego tradycyjny nadzór nad AI to pomija

Większość regulacji AI skupia się na tym, co AI robi źle — dyskryminujące wyniki, naruszenia prywatności, awarie techniczne. Ale nie odnosi się do tego, co AI robi nam — jak zmienia nasze procesy poznawcze, nawyki myślowe, zdolność do niezależnego osądu.

Decision Integrity™ to metodologia, która odpowiada na Behavioral AI Risk. Dostarcza ramy, narzędzia i wskaźniki pozwalające mierzyć, monitorować i ograniczać te ryzyka — chroniąc jakość ludzkich decyzji w środowiskach coraz silniej kształtowanych przez sztuczną inteligencję.

O autorze

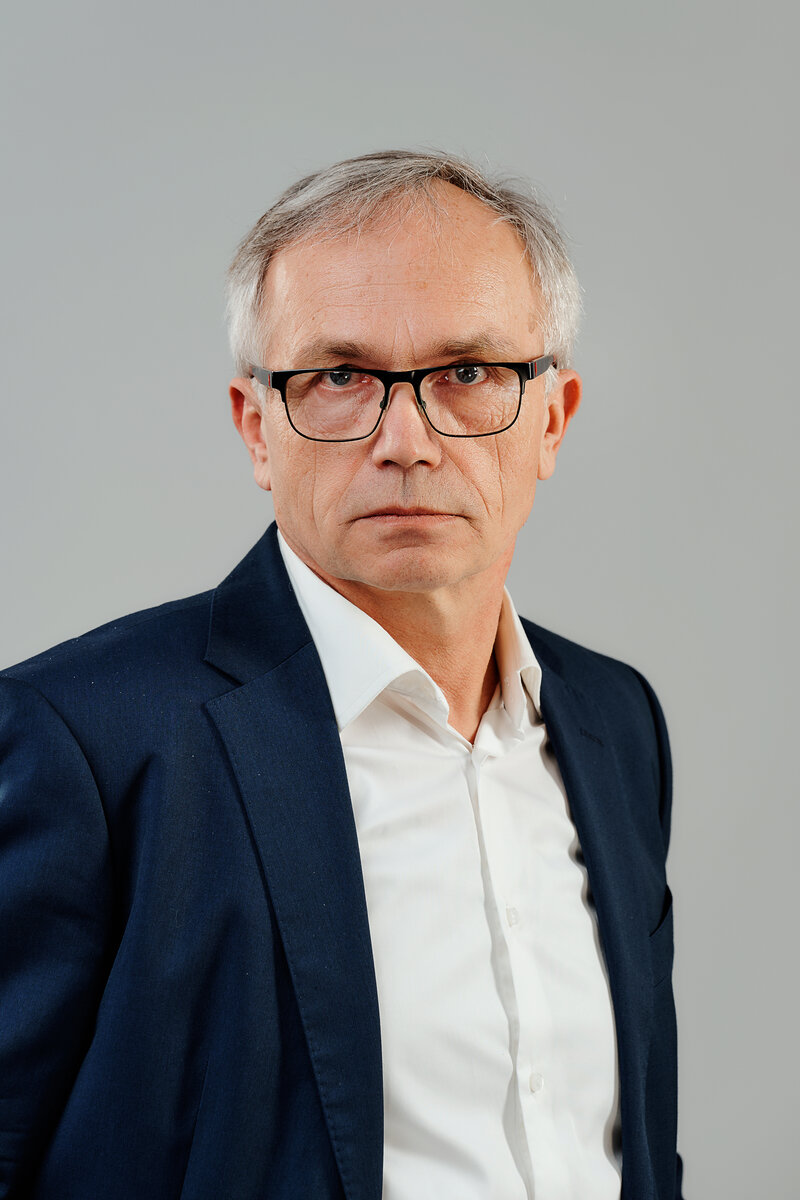
Stefan Podedworny — Creator of Decision Integrity™, Expert in Behavioral AI Risk

Stefan Podedworny

Twórca Decision Integrity™ · Ekspert Behavioral AI Risk

Doktoraty w przygotowaniu

SGH Szkoła Główna Handlowa w Warszawie

Ekonomia — ekonomia behawioralna

Uniwersytet Warszawski

Językoznawstwo — językoznawstwo korpusowe

Stefan Podedworny jest twórcą Decision Integrity™ — ekspertem na styku ekonomii behawioralnej i nadzoru nad AI. Jego praca wyznacza nową dziedzinę Behavioral AI Risk, badając, jak systemy AI systematycznie wpływają na ludzki osąd, wzmacniają błędy poznawcze i obniżają jakość decyzji. Przygotowuje dwa doktoraty — z ekonomii (ekonomia behawioralna) w Szkole Głównej Handlowej w Warszawie oraz z językoznawstwa (językoznawstwo korpusowe) na Uniwersytecie Warszawskim.

Idea stojąca za Decision Integrity™

Podczas gdy większość działań w obszarze nadzoru nad AI skupia się na tym, co AI robi źle — naruszenia danych, uprzedzenia algorytmiczne, dyskryminujące wyniki — Stefan dostrzegł ryzyko subtelniejsze i groźniejsze: to, co AI robi nam. Jak zmienia sposób, w jaki postrzegamy problemy, oceniamy możliwości i wyciągamy wnioski. Jak czyni nas mniej krytycznymi, mniej rozważnymi i bardziej zależnymi od systemów, które symulują rozumienie, choć go nie posiadają.

Decision Integrity™ łączy ekonomię behawioralną z nadzorem nad AI, dostarczając ramy, narzędzia i wskaźniki pozwalające mierzyć i ograniczać ryzyka, które tradycyjne podejścia pomijają.

Kluczowe Osiągnięcia

HRI Score™

Autorska metoda oceny ryzyka behawioralnego AI

ContextRot Framework

Modelowanie degradacji informacji w systemach AI

AI Act Readiness Tool

Praktyczna ocena zgodności z EU AI Act

Behavioral AI Risk Taxonomy

Systematyczny katalog ryzyk poznawczych w systemach AI

Poza Badaniami

Praca Stefana nie jest wyłącznie akademicka — jest praktyczna. Decision Integrity™ dostarcza narzędzia wykorzystywane przez specjalistów ds. zgodności, zespoły AI i decydentów do rozumienia i ograniczania ryzyk behawioralnych we wdrożeniach AI.

„Pytanie nie brzmi, czy AI będzie wpływać na ludzkie decyzje — już to robi. Pytanie brzmi, czy zachowamy świadomość i zdolność krytyczną, by rozpoznać, kiedy robi to w sposób podważający jakość naszego osądu.”

— Stefan Podedworny

Ramy Decision Integrity™

Ramy, narzędzia i wskaźniki

Każda z ram odnosi się do innego wymiaru Behavioral AI Risk. Razem tworzą Decision Integrity™ — spójną metodologię rozumienia, mierzenia i ochrony jakości decyzji w środowiskach wspieranych przez AI.

Wyróżniona metoda

HRI Score™

Human Risk Impact Score

Autorska metoda oceny ryzyka behawioralnego AI

HRI Score™ mierzy, w jakim stopniu systemy AI obniżają jakość ludzkich decyzji. Bierze pod uwagę manipulację obciążeniem poznawczym, efekty framingu, zależność od automatyzacji oraz osłabienie zdolności krytycznego myślenia w interakcjach człowiek–AI.

Opracowany przez Stefana Podedwornego w ramach metodologii Decision Integrity™, HRI Score™ daje ilościową podstawę decyzji w obszarze nadzoru nad AI — pozwala przejść od ocen subiektywnych do mierzalnej oceny ryzyka.

Pozostałe ramy i narzędzia

Decision Integrity Index™

Ocena i ranking AI

Niezależny Ranking Platform Agentic AI

Niezależny, neutralny wobec dostawców ranking 30 platform Agentic AI — łączący ewaluację techniczną z wpływem behawioralnym na jakość ludzkich decyzji. Pomaga organizacjom wybierać AI zgodnie z wymaganiami biznesu, bezpieczeństwa i EU AI Act.

pre-HRAIS

Ocena wstępna

Wstępna Ocena Ryzyka Ludzkiego AI

Szybka metoda wstępnej oceny, przeznaczona do pierwszego przeglądu systemów AI przed pełną oceną HRI Score™.

AI Act Readiness

Ocena zgodności

Ramy zgodności z EU AI Act

Oceń klasyfikację ryzyka, obowiązki w zakresie przejrzystości i wymogi nadzoru ludzkiego dla Twojego systemu AI w świetle europejskiego AI Act — w 10 minut.

ContextRot

Badania nad degradacją

Degradacja Kontekstu w Systemach AI

Badania nad postępującą degradacją jakości kontekstu, spójności i zgodności z faktami podczas dłuższych interakcji z AI.

REFLECTOR

Narzędzie Wsparcia Decyzji

Detektor Błędów Decyzyjnych AI

Narzędzie AI oparte na ekonomii behawioralnej, które wykrywa, co naprawdę wpływa na Twoje decyzje: presję, manipulację, błędy poznawcze i sugestie AI. Zawiera diagnostyczny Miernik Odporności.

Behavioral AI Risks

Taksonomia Ryzyk

Taksonomia Ryzyk Poznawczych i Behawioralnych

Systematyczna taksonomia ryzyk behawioralnych wprowadzanych przez systemy AI do ludzkich procesów decyzyjnych. Kataloguje mechanizmy wpływu AI na błędy poznawcze i kalibrację osądu.

Badania w toku

Human Oversight

Ład i nadzór

Architektura i zasady nadzoru

Ramy nadzoru określające strukturalne i proceduralne wymagania dla rzeczywistego nadzoru ludzkiego nad decyzjami wspieranymi przez AI.

Badania w toku

Manifest

O integralności ludzkich decyzji

Stanowisko dotyczące relacji między sztuczną inteligencją a jakością ludzkiego osądu — poruszające nie to, co AI potrafi, lecz to, co może po cichu zmienić.

01

Niewidzialna Zmiana

Sztuczna inteligencja stała się aktywnym uczestnikiem procesu, w którym ludzie postrzegają problemy, oceniają opcje i dochodzą do wniosków. Ta zmiana jest w dużej mierze niewidoczna — i właśnie to czyni ją tak istotną. Gdy systemy zaprojektowane z myślą o efektywności zaczynają kształtować pytania, które zadajemy, i pewność, jaką odczuwamy wobec odpowiedzi, integralność ludzkiego procesu decyzyjnego staje pod znakiem zapytania.

02

Błędy Poznawcze na Skalę

Systemy AI nie tylko odzwierciedlają ludzkie błędy poznawcze — wzmacniają je. Efekt potwierdzenia utrwala się, gdy algorytmy wyświetlają informacje zgodne z wcześniejszymi przekonaniami. Efekt zakotwiczenia nasila się, gdy AI przedstawia pewną siebie początkową odpowiedź. Te same podatności poznawcze, które nauki behawioralne od dawna identyfikują, działają teraz na bezprecedensową skalę, za pośrednictwem technologii, której większość ludzi ufa bezwarunkowo.

03

Atrofia Krytycznego Myślenia

Gdy odpowiedzi generowane przez AI pojawiają się natychmiast — spójne, wyraziste i pozornie autorytatywne — słabnie potrzeba kwestionowania, weryfikacji i namysłu. Z czasem prowadzi to nie do lepiej uzasadnionych decyzji, lecz do niebezpiecznej zależności od systemów, które symulują rozumienie, choć go nie posiadają. Stopniowe osłabianie niezależnego osądu jest być może najbardziej niedocenianym ryzykiem obecnej drogi technologicznej.

04

Fałszywa Pewność i Wpływ Semantyczny

Halucynacje — wiarygodne, ale zmyślone stwierdzenia — przedstawiane są z taką samą pewnością języka jak zweryfikowane fakty. Ramowanie znaczeniowe (framing), czyli sposób, w jaki AI porządkuje i przedstawia informacje, subtelnie wpływa na to, jak odbiorcy interpretują fakty. Tworzy to środowisko, w którym fałszywa pewność kwitnie, a granica między wiedzą a zmyśleniem staje się coraz trudniejsza do rozpoznania.

05

Jakość Ponad Automatyzację

Dominująca narracja przedstawia adopcję AI jako bezwarunkowe dobro — szybciej, taniej, wydajniej. Ale efektywność bez integralności nie jest postępem. Celem nie powinno być automatyzowanie jak największej liczby decyzji, lecz zapewnienie, że decyzje wspierane przez AI zachowują jakość, rozwagę i wrażliwość kontekstową, jakich wymagają istotne wybory.

06

Imperatyw Nadzoru Ludzkiego

Ochrona integralności decyzji nie jest stanowiskiem antytechnologicznym. To uznanie, że najważniejsze decyzje — te wpływające na ludzi, organizacje i społeczeństwa — wymagają ludzkiej świadomości, odpowiedzialności i zdolności do kwestionowania systemów, które dostarczają im informacji. Nadzór nie jest ograniczeniem; jest warunkiem wdrażania AI godnego zaufania.

Koncepcja Autorska

ContextRot: Cicha Degradacja Decyzji Wspieranych przez AI

ContextRot opisuje postępującą utratę spójności, trafności i wierności kontekstowej podczas dłuższych interakcji z dużymi modelami językowymi. To nie awaria — to strukturalna cecha tego, jak te systemy przetwarzają i utrzymują informacje w czasie.

Zjawisko to ma bezpośrednie znaczenie dla każdego, kto podejmuje ważne decyzje w oparciu o długotrwałą analizę wspomaganą przez AI: badaczy, strategów, decydentów oraz każdego specjalisty, którego praca zależy od wiarygodności wniosków generowanych przez AI.

Przebieg degradacji

Faza 1

Erozja Kontekstu

Początek interakcji

Początkowe ograniczenia, instrukcje i niuanse kontekstowe zaczynają tracić na znaczeniu w miarę rozwoju rozmowy. System faworyzuje ostatnie wymiany, stopniowo pomniejszając wagę pierwotnego kontekstu.

Niskie ryzyko
Faza 2

Dryf Semantyczny

Przedłużone sesje

Terminologia zaczyna się subtelnie przesuwać. Definicje ustalone na początku konwersacji są reinterpretowane. System wprowadza wariacje znaczeniowe, które kumulują się z każdą wymianą, tworząc powoli rozbieżny krajobraz semantyczny.

Umiarkowane ryzyko
Faza 3

Kumulacja Halucynacji

Przedłużona interakcja

Sfabrykowane elementy wchodzą do konwersacji — początkowo drobne, potem budujące się na sobie nawzajem. Każda halucynacja staje się punktem odniesienia dla kolejnych odpowiedzi, tworząc wewnętrznie spójną, ale faktycznie niewiarygodną strukturę wiedzy.

Wysokie ryzyko
Faza 4

Nasycenie Fałszywą Pewnością

Głęboka sesja

Pewność języka systemu pozostaje bez zmian — lub wzrasta — podczas gdy rzeczywista wiarygodność się pogarsza. Luka między postrzeganą a rzeczywistą jakością odpowiedzi osiąga maksimum, tworząc najgroźniejszą sytuację dla decydentów.

Ryzyko krytyczne

Wymiary Ryzyka Poznawczego

Przeciążenie Poznawcze

W miarę wydłużania się sesji, wolumen treści generowanych przez AI przekracza ludzką zdolność krytycznej weryfikacji. Decydenci zaczynają akceptować wyniki bez odpowiedniej kontroli — nie z zaufania, ale ze zmęczenia.

Utrata Instynktu Weryfikacji

Płynność i spójność odpowiedzi AI tworzą fałszywe poczucie wiarygodności. Z czasem nawyk kwestionowania i sprawdzania zanika, ustępując milczącemu założeniu, że spójność równa się trafności.

Kumulacja Fabrykacji

W przeciwieństwie do ludzkich błędów pamięci, halucynacje AI nie korygują się samoistnie. Każdy sfabrykowany element staje się fundamentem kolejnych odpowiedzi, tworząc łańcuchy błędów wewnętrznie logiczne, ale fundamentalnie oderwane od rzeczywistości.

Niewidzialna Degradacja

ContextRot nie generuje żadnych widocznych sygnałów ostrzegawczych. Nie ma komunikatu o błędzie, wskaźnika niepewności ani alertu degradacji. Przejście od wiarygodnych do niewiarygodnych wyników jest płynne i niewidoczne dla użytkownika.

Poznaj dedykowane badania ContextRot na contextrot.eu

Program Badawczy

Publikacje i Working Papers

Badania akademickie i stosowane badające styk sztucznej inteligencji, ekonomii behawioralnej, nauk o poznaniu i nadzoru nad AI.

Artykuł Źródłowy

2025

Decision Integrity Index: A Behavioral Methodology for Evaluating Agentic AI Systems

Artykuł stanowiący fundament podejścia Decision Integrity™. Przedstawia behawioralną metodologię oceny agentycznych systemów AI — przenosząc uwagę z wydajności technicznej na wpływ AI na ludzkie poznanie, jakość osądu i autonomię decyzyjną. Określa teoretyczne i praktyczne podstawy całej metodologii Decision Integrity™.

OpublikowanySSRN →
Working Paper

2026

Wzmacnianie Błędów Poznawczych w Środowiskach Decyzyjnych Wspomaganych przez AI

Analiza tego, jak systemy AI systematycznie wzmacniają istniejące błędy poznawcze — w tym efekt potwierdzenia, efekt zakotwiczenia i heurystykę dostępności — poprzez sposób prezentowania informacji, poziom pewności odpowiedzi i projektowanie interakcji.

W przygotowaniu
Nota Badawcza

2026

Efekty Ramowania Znaczeniowego w Odpowiedziach Dużych Modeli Językowych

Analiza tego, jak struktura językowa i sposób ramowania tekstów generowanych przez AI wpływają na interpretację i ważenie informacji przez ludzkich odbiorców. Bada różnicę między treścią informacyjną a strukturą perswazyjną w odpowiedziach AI.

W przygotowaniu
Framework Paper

2025

HRAIS: Metodologia Oceny Ryzyka Ludzkiego w Systemach AI

Wprowadzenie metodologii Human Risk AI Scoring — uporządkowanego podejścia do oceny tego, w jakim stopniu wdrożenia AI osłabiają autonomię decyzyjną człowieka, zdolność krytycznego myślenia i trafność osądu.

Artykuł Koncepcyjny

2025

ContextRot: Modelowanie Degradacji Informacji w Długich Interakcjach z AI

Formalna charakterystyka zjawisk degradacji kontekstu w dużych modelach językowych podczas długich sesji. Proponuje ramy pozwalające zrozumieć, jak kumulacja halucynacji, dryf znaczeniowy i fałszywa pewność współdziałają w miarę trwania rozmowy.

Stanowisko

2026

Rozróżnienie Między Nominalnym a Efektywnym Nadzorem Ludzkim nad AI

Krytyczna analiza obecnych podejść do nadzoru ludzkiego nad AI. Pokazuje, że wiele istniejących mechanizmów nadzoru jest jedynie formalnych — obecnych w formie, lecz pustych w treści — i proponuje kryteria oceny ich rzeczywistej skuteczności.

W przygotowaniu
Raport Badawczy

2026

Fałszywa Pewność jako Ryzyko Systemowe w Strategicznych Decyzjach Wspieranych przez AI

Badanie tego, jak pewne prezentowanie niepewnych lub zmyślonych informacji przez systemy AI tworzy ryzyko systemowe przy decyzjach strategicznych — w tym inwestycyjnych, dotyczących polityki publicznej i strategii organizacji.

W przygotowaniu

Badania Eksperymentalne

Udział w Badaniach

Decision Integrity™ rozwija eksperymentalne inicjatywy badawcze badające granice ludzkiego poznania w środowiskach, w których pośredniczy AI.

Ryzyka behawioralne AIRamowanie znaczenioweWpływ sensoryczny na decyzjeDegradacja kontekstuŚwiadomość ludzka w środowiskach AI

Aktualne Badania Eksperymentalne

ENGH

Środowisko Badawcze

Eksploracyjne środowisko badań behawioralnych związane z Hipotezą Bramy Nosowej i wpływem sensorycznym na ludzkie procesy decyzyjne. Badanie analizuje, jak sygnały olfaktoryczne, gotowość emocjonalna i filtrowanie poznawcze wchodzą w interakcję z wpływem semantycznym, kształtując ludzki osąd i mechanizmy decyzyjne.

Sygnały olfaktoryczne i sensoryczne

Gotowość emocjonalna

Ścieżki wpływu semantycznego

Mechanizmy filtrowania poznawczego

Ludzkie procesy decyzyjne

Uczestnictwo

Kod sesji

235

Typ badania

Behawioralne / Sensoryczne

Status

Przyjmujemy uczestników
sygnał sensoryczny

Dla firm

Wybierasz AI dla firmy?

Pomogę ustalić kryteria, sprawdzić deklaracje dostawców i udokumentować decyzję — z uwzględnieniem wpływu AI na ludzi, którzy będą z niego korzystać.

Kontakt

Skontaktuj się

Zapytania o współpracę badawczą, pytania dotyczące ram metodologicznych lub ogólna korespondencja związana z Decision Integrity™.